
抽卡式生成的结构性问题
纯文字生成视频,本质是让模型同时决定三件事:画面里有什么(内容)、镜头怎么摆(构图)、动作怎么走(运动)。三件事都不确定,每生成一次就是一次全新的随机组合。这带来三个后果:
- 命中率低:意图到画面的翻译链条太长,每次roll都是重新掷骰子;
- 不可累积:roll 出一段 80 分的,无法在它基础上改进,只能继续roll碰 90 分;
- 无法成剧:单段视频好看没用,镜头之间接不上——角色换了脸,场景换了光。
问题不在模型不够好,而在把所有自由度都交给了模型。可控的做法是把自由度分层:人决定关键状态,模型补过程。
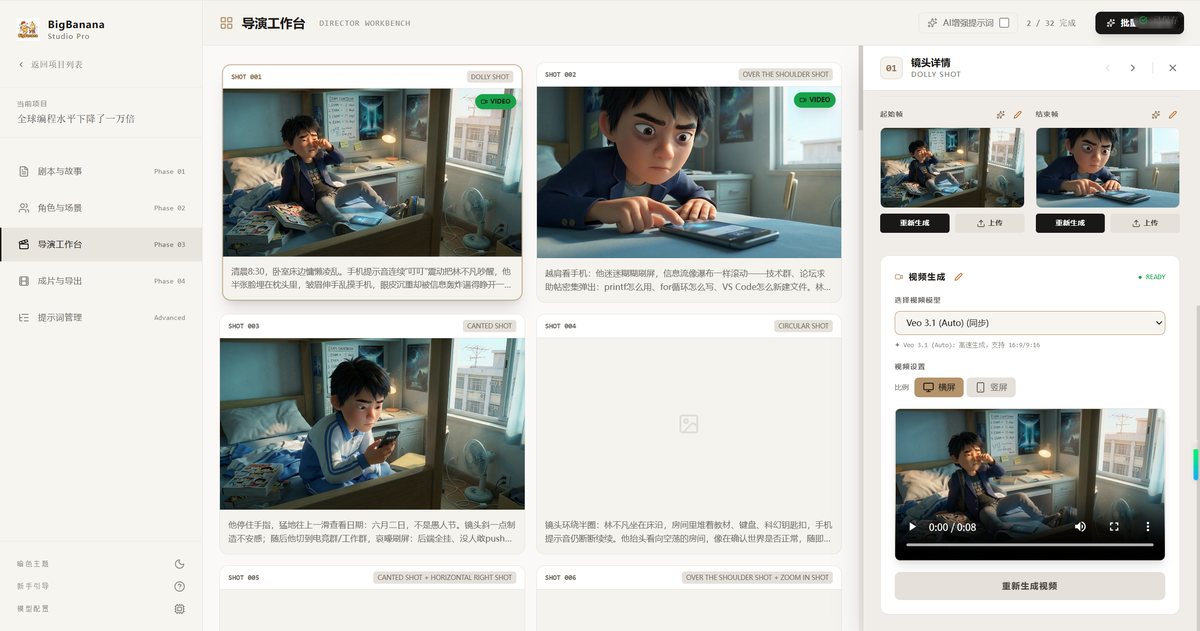
关键帧驱动:把不确定性关进两帧之间
关键帧驱动的流程只有三步:
- 生成起始帧:受角色定妆照、场景概念图、道具参考约束,确定镜头开始时的确切画面;
- 生成结束帧:同样的约束体系,确定镜头结束时的画面;
- 插值生成:模型在两帧之间生成平滑的视频过渡。
起点和终点都锁死了,模型只剩一个问题要回答:怎么从 A 到 B。这就是从"开放题"到"填空题"的转变——填空题的答错率远低于开放题。
资产约束:两帧为什么不会跑偏
关键帧本身也是 AI 生成的,它为什么不漂移?因为每一帧的生成都被三层资产强约束:
| 约束 | 锁住什么 | 来源 |
|---|---|---|
| 角色定妆照 | 角色五官、发型、体态 | 角色资产库 |
| 场景概念图 | 空间结构、光影基调 | 场景资产库 |
| 道具与服装参考 | 关键道具形态、当前造型 | 上下文自动装配 |
所以关键帧不是"凭空画一张图",而是在既定视觉体系内渲染一个具体时刻。体系是统一的,帧就是统一的;帧是统一的,视频就是统一的;镜头是统一的,剧就是统一的。
它和传统动画关键帧的关系
这个名字不是蹭概念,方法论确实同源:传统动画也是先有关键帧(原画),再由动画师手绘中间帧(中割)。区别只在中间帧的来源:
- 传统:原画师定关键状态 → 动画师手绘中割 → 成片;
- AI 驱动:创作者定关键状态 → 模型插值中割 → 成片。
对创作者的职责要求没有变——把控关键状态依然是人的工作;变的是中割成本,从按帧计价的人工变成一次 API 调用。这也是"工业化工作流"的含义:结构借鉴成熟工业,产能交给新工具。
什么时候不该用关键帧
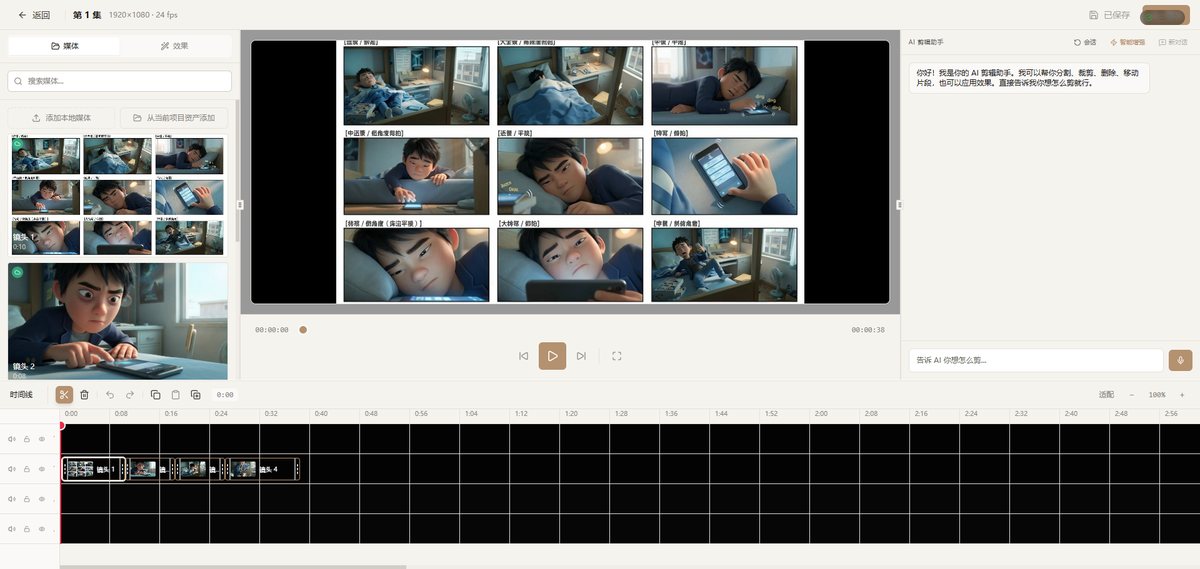
诚实地说,关键帧驱动不是万能的。两类场景文生视频更合适:氛围空镜(云、雨、光影变化,没有具体主体要锁)和风格探索(还没想清楚要什么,靠roll找感觉)。关键帧的价值在叙事镜头上——有人物、有动作、有上下文的镜头。把工具用在它擅长的环节,比争论哪种方式"更强"有意义。