
先弄明白:为什么会变脸
生成模型没有记忆。你写"黑发红瞳的少女剑士",模型每次都会生成一个符合描述但细节不同的人:发型分线变了、瞳色深了两度、脸型圆了一点。单看每张图都没问题,连起来就是换了个人。
提示词写得再细也解决不了这个问题——文字描述无法唯一确定一张脸。角色一致性真正的解法是给模型一个视觉锚点:不是描述她长什么样,而是直接给她看长什么样。
第一重:定妆照系统——全片的视觉锚点
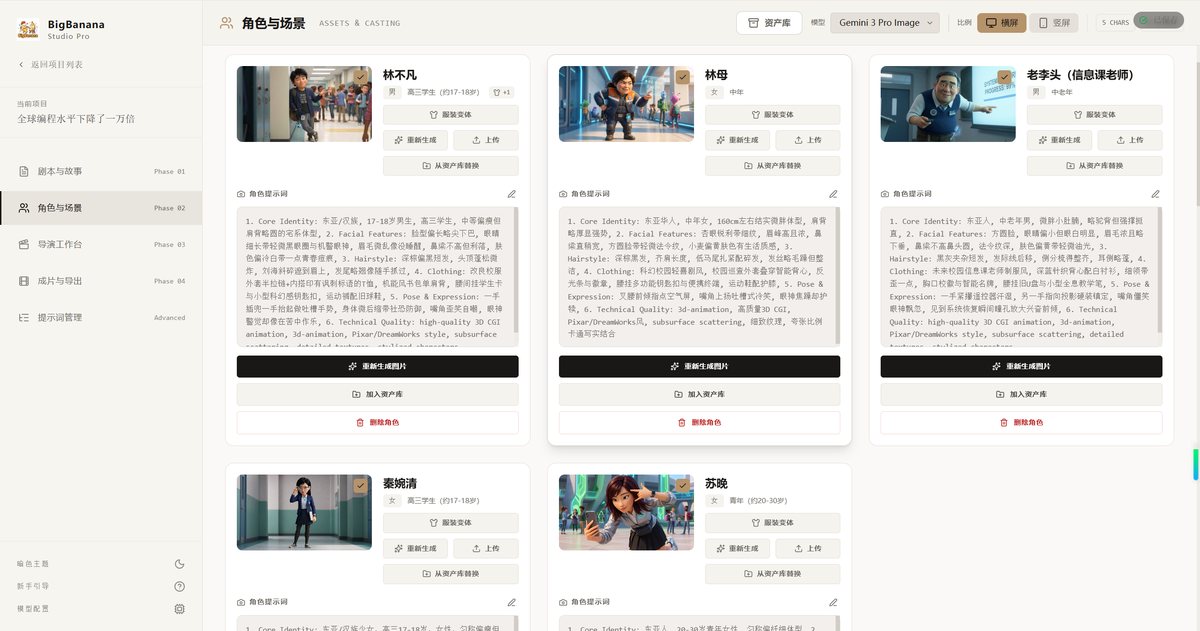
为每个常驻角色生成一张标准参考图(定妆照),作为全片所有镜头的生成依据。做法上有三个要点:
- 先定妆,后开工:任何镜头生成之前,先把常驻角色的定妆照做完。没有锚点的镜头都是在攒返工。
- 定妆照求稳不求艳:目标是稳定可复用——五官清晰、光线中性、角度标准。单张惊艳但特征模糊的图,做锚点反而不好用。
- 所有镜头都挂参考:生成时自动携带定妆照作为强约束,模型在"画这个人"而不是"画一个这样的人"。
第二重:衣橱系统——换衣服不换人
连载剧情里角色必然换装:日常、战斗、伪装、受伤。直接生成新造型,脸往往跟着变。衣橱系统的做法是所有造型变体都基于定妆照的 Base Look 生成:
- 定妆照确定角色的 Base Look(脸、发型、体型基准)。
- 衣橱里的每套造型(日常装、战斗装、受伤状态)都从 Base Look 派生。
- 镜头生成时按当前剧情装配对应造型,面部特征被 Base Look 锁定。
这就是"换衣服不换脸"的实现方式:造型是派生物,不是重新生成物。
第三重:上下文感知生成——镜头知道前面发生了什么
前两重解决"人"的一致,第三重解决"戏"的一致。生成一个镜头时,系统自动读取当前上下文:
- 当前场景概念图——保证空间与光影连续;
- 角色当前服装参考——保证剧情内造型连续(上一镜头脱了外套,下一镜头就不会穿回来);
- 涉及的道具参考——保证信物、武器等关键道具形态统一。
不是每个镜头从零开始,而是镜头"知道"前面的剧情。三重机制叠加后,随机漂移被压到很低,剩下的问题镜头靠人工检查个别返修。
三重机制怎么配合:一张表看懂
| 机制 | 解决的问题 | 生效范围 | 制作时机 |
|---|---|---|---|
| 定妆照系统 | 角色长相漂移 | 全片所有镜头 | 镜头开工之前 |
| 衣橱系统 | 换装导致变脸 | 涉及换装的镜头 | 随剧情逐步补充 |
| 上下文感知生成 | 场景、服装、道具的剧情连续性 | 每个镜头生成时 | 自动生效 |
一句话总结:定妆照锁"人",衣橱锁"装",上下文锁"戏"。三层都稳了,连载才立得住。