
为什么直接生成视频是低效的
直接文字生成视频的问题在于:你在用最贵的环节做探索。构图不满意、机位不对、动作方向错了——这些本该在设计阶段就发现的问题,只有等视频生成出来才看得见,而每发现一次就重生成一次。
静态图便宜、快、可批量比较。九宫格分镜的本质,就是把探索成本从视频环节挪到静态图环节:同一个镜头,一次出九个方案,先看再选。
九宫格的完整流程:四步
第一步:写清镜头意图
进入九宫格之前,先把这个镜头的意图写明白:谁在画面里、在做什么、情绪是什么、这段戏要传达什么。意图模糊的镜头,出多少方案都选不出来——你不是在选构图,是在找"这段戏到底想说什么"。
第二步:一次生成九个方案
在工作台里对同一镜头发起九宫格预演,AI 会给出九个不同机位与动作安排的方案:远景、中景、特写、俯仰角、过肩……所有方案都基于已沉淀的角色定妆照与场景概念图,所以预演阶段就能看到角色和场景的真实样子。
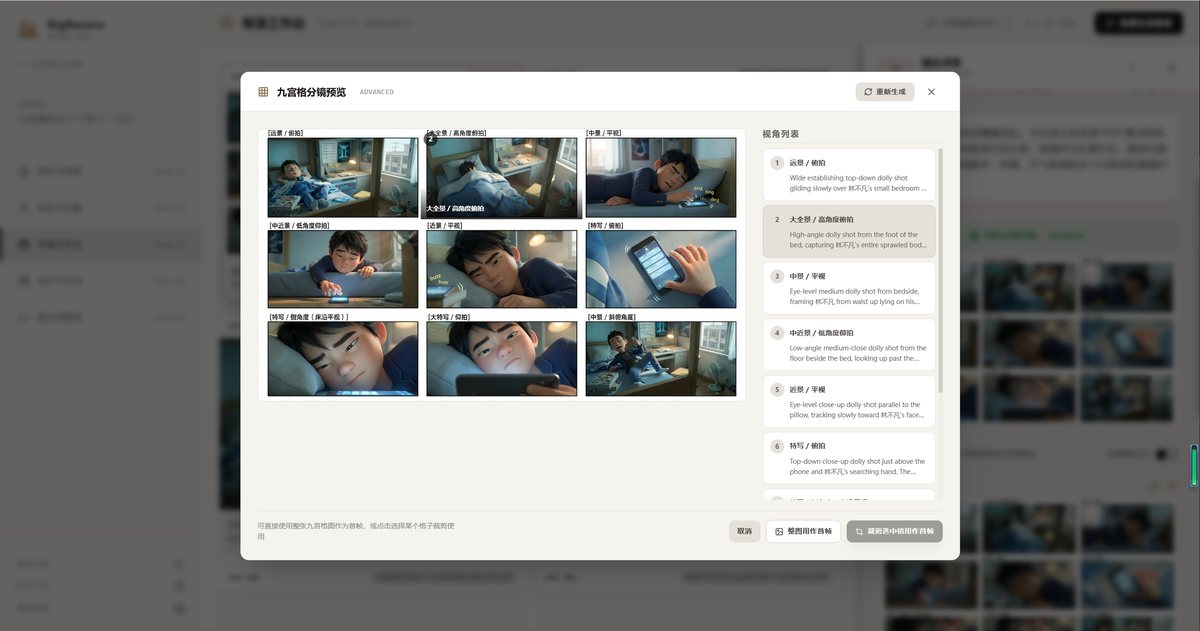
第三步:比较,选出对的构图
选格子的标准只有一个:哪个方案把这个镜头的意图讲得最清楚。情绪镜头看视线与留白,动作镜头看方向与动势,关系镜头看站位与距离。选中之后,其他八张就是这次决策的"废案"——但它们的存在让这次决策有依据。
第四步:把选中的构图带进关键帧
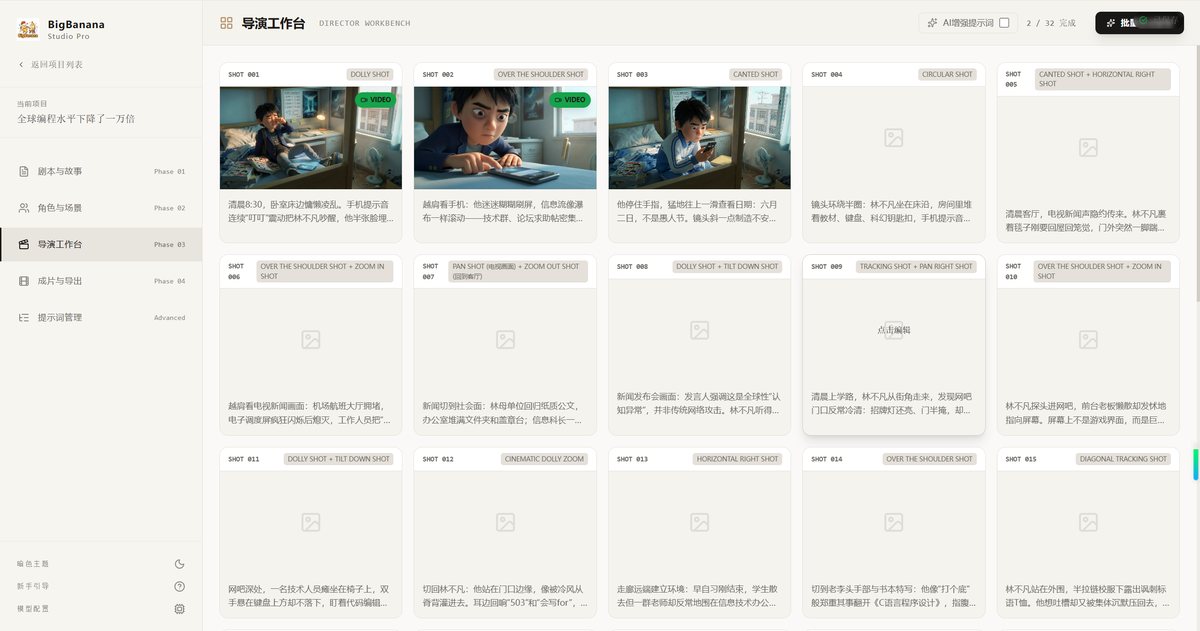
选中格子的构图与动作方向,作为起始帧与结束帧的生成依据。两帧确认后,再由模型插值生成视频过渡。到这里,视频生成已经不再是探索,而是执行一个已经确认过的方案。
哪些镜头值得过九宫格
不是每个镜头都要预演。按投入产出排序,优先级从高到低:
| 镜头类型 | 是否预演 | 原因 |
|---|---|---|
| 多角色同框 | 必预演 | 站位、视线、遮挡关系复杂,返工率最高 |
| 关键情绪节点 | 必预演 | 构图直接决定情绪表达,值得多方案比较 |
| 动作转场 | 建议预演 | 起止状态要明确,直接影响关键帧质量 |
| 常规对话正反打 | 可跳过 | 机位模式固定,直接进关键帧 |
| 空镜 / 过场 | 可跳过 | 成本低,不满意直接重生成 |
给非美术背景的人:判断比手绘重要
传统分镜的门槛是手绘,九宫格把这个门槛移走了。你需要的能力是判断:看出哪个方案讲故事讲得清楚。这种判断力你在看剧看电影时已经练了十几年——知道哪个镜头"对味",就能做九宫格的选择题。至于运镜术语,中景、俯拍、过肩,在工作台的镜头描述里用起来就行,AI 能理解。